 灯凛科技DengLin Cloud IDC
400-839-62057×24 技术支持
灯凛科技DengLin Cloud IDC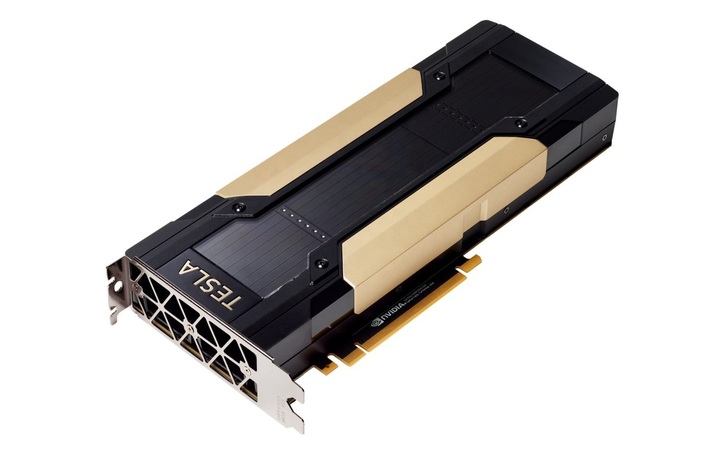
算力池部署在深圳液冷机房,单柜功率密度 12kW,风冷方案下 8 卡整机很难稳定跑到满载,液冷是必要的。单机配 2 颗 32 核处理器、512G 内存、8T NVMe 本地盘,机内 GPU 通过 NVLink 桥接,节点间 25G RDMA 互联。
镜像环境预装 CUDA 12.4、PyTorch 2.3、vLLM 与 TensorRT-LLM,另有常用视觉与语音模型的开箱镜像。客户可上传自有镜像,单镜像大小上限 30G,构建完成约 2 分钟。
计费方式灵活:按小时 38 元/卡起,按天 680 元,按月 12800 元;8 卡整机按天 4980 元。抢占式实例便宜但可能被回收,独占实例价格上浮约 20% 但资源锁定。新用户可申请 8 卡时免费试用额度。
| 卡型 | 24G / 48G / 80G 显存推理加速卡,被动散热 |
|---|---|
| 整机形态 | 单机 8 卡,NVLink 桥接,PCIe 4.0 x16 |
| 主机配置 | 2×32 核 CPU / 512G 内存 / 8T NVMe 本地盘 |
| 节点互联 | 25G RDMA,机内 GPU 直连 |
| 镜像 | CUDA 12.4 / PyTorch 2.3 / vLLM / TensorRT-LLM |
| 存储 | 本地 NVMe 高速盘,另可按 0.35 元/GB/月 挂载共享存储 |
| 带宽 | 默认 10M 公网,可升至 100M |
| 计费 | 按小时 / 按天 / 按月,抢占式与独占式两种 |
| 交付 | 镜像就绪后 10 分钟内开机 |
| 监控 | 显存占用、功耗、温度、利用率面板可视化 |
以下场景是客户实际部署中出现频率最高的几类,可直接对号入座;不在列表里的业务也可以提需求,我们按业务模型给建议。
7B 级模型做 INT8 量化后可在单卡 24G 上推理,并发约 30 路;13B 级建议 2 卡并行;70B 级至少 4 卡,且需要开启张量并行。具体并发取决于上下文长度与输出长度。
会。抢占式实例在资源紧张时可能被回收,平台会提前 60 秒通知并保存检查点。对不能中断的训练任务,建议选独占实例。
可以。平台提供 root 权限与容器两种模式,容器模式下可自定义镜像,root 模式下可自行 apt/pip 安装,但实例重置后环境不保留,建议把依赖固化到镜像里。